学位论文简介
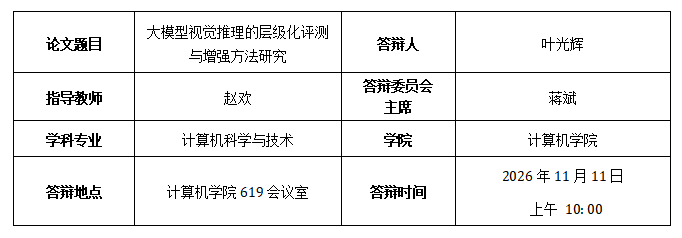
针对多模态大模型视觉推理中功能层次混合、评测难以定位能力缺口以及增强方法针对性不足等问题,本文提出感知、理解、推理和交互的视觉推理层级化框架,沿“任务定义—基准构建—能力诊断—反馈增强”展开研究。主要研究内容归纳如下:
(1) 图表精细感知评测与可解释性解析。为解决科学图表整体内容较易判断、局部事实却难以准确核验的问题,构建覆盖文本生成图表与图表生成描述的双向评测基准。结合科学领域表征增强,分别评价整体相关性与细节准确性,定位不忠实元素并生成判断依据,再将评估结果转化为图表修正反馈。
(2) 文化深层理解评测与文化表达增强。为考察文化知识从识别、综合判断到视觉表达的递进能力,构建基本知识问答、综合文化评价和知识运用生成三类任务,并建立六维专家评价规范。进一步提出分层自动评估与文化语境增强方法,依据不同评价维度进行细粒度判断,并利用风格要素和文化故事改善生成图像的文化表达。
(3) 多图关系推理评测与线索链接。为解决多幅关联图像中实体对应、时序变化和外部知识难以组织的问题,构建涵盖多粒度比较、视觉链接推理和外部知识寻求的评测基准。提出带实体区域锚定的视觉化知识线索,通过提出的观察、查找与融合三阶段多图推理框架,将实体、属性、关系及相关知识组织为辅助图像,帮助模型定位并关联分散证据。
(4) 图文持续交互评测与参与度提升。为兼顾当前回复质量与长期会话表现,提出长短期反馈对话优化方法,将轮次级和会话级评价转化为反馈信号。进一步构建音频增强视觉对话任务,采用文本与音频交错建模,并从情感、注意和回复三个维度评价参与度,提高多轮交互中的持续回应能力。
主要学术成果
[1] Guanghui Ye, Huan Zhao*, Zhixue Zhao*, Tengfei Ma, Kehan Wang, Steffen Eger, Zhihua Jiang. SCIEval: Evaluating and Benchmarking the Faithfulness of Scientific Image Generation and Interpretation with Large Multimodal Models [C]. IEEE/CVF Conference on Computer Vision and Pattern Recognition. IEEE, 2026: 29760-29770.(CCF-A,第一作者)
[2] Guanghui Ye, Huan Zhao*, Qin Zhu, Fengnan Li, Jiaqi Li, Yixian Shen, Zhonghao Ren, Zhihua Jiang*. Automatic and Reliable Evaluation for Academic Caption-to-Figure Generation with LMMs [C]. 64th Annual Meeting of the Association for Computational Linguistics. Association for Computational Linguistics, 2026: 44406-44423.(CCF-A,第一作者)
[3] Guanghui Ye, Huan Zhao*, Yingxue Gao, Zhixue Zhao, Kehan Wang, Xupeng Zha, Zhihua Jiang*. Making Visual Dialogue More Engaging: A New Task, Method, and Metric [C]. 40th AAAI Conference on Artificial Intelligence. AAAI Press, 2026: 16145-16153.(CCF-A,第一作者)
[4] Guanghui Ye, Huan Zhao*, Zhixue Zhao, Yang Liu, Xupeng Zha, Zhihua Jiang. Knowledge Image Matters: Improving Knowledge-Based Visual Reasoning with Multi-Image Large Language Models [C]. 63rd Annual Meeting of the Association for Computational Linguistics. Association for Computational Linguistics, 2025: 21883-21896.(CCF-A,第一作者)
[5] Guanghui Ye, Huan Zhao*, Yixian Shen, Jiaqi Li, Fengnan Li, Zhihua Jiang*, Keqin Li. Generating Multi-Modal Knowledge Clues as an Image: Toward Improving Image-Sequence Reasoning with Assisted Visual Input [J]. IEEE Transactions on Circuits and Systems for Video Technology, 2026, 36(8): 11197-11214.(SCI 1区,第一作者)
[6] Guanghui Ye, Huan Zhao*, Zixing Zhang, Zhihua Jiang. UniDE: A Multi-Level and Low-Resource Framework for Automatic Dialogue Evaluation via LLM-Based Data Augmentation and Multitask Learning [J]. Information Processing & Management, 2025, 62(3): 104035.(SCI 1区,第一作者)
[7] Guanghui Ye, Huan Zhao*, Zixing Zhang, Xupeng Zha, Zhihua Jiang. LSTDial: Enhancing Dialogue Generation via Long- and Short-Term Measurement Feedback [C]. 2024 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies. Association for Computational Linguistics, 2024: 5857-5871.(CCF-B,第一作者)
[8] Guanghui Ye, Huan Zhao*, Bo Li, Haijiao Chen, Zhixue Zhao, Zhihua Jiang, Keqin Li. CCDE: A Compact and Competitive Dialogue Evaluation Framework via Knowledge Distillation of Large Language Models [J]. IEEE Transactions on Computational Social Systems, 2025, 12(6): 5127-5139.(JCR一区,第一作者)
[9] Guanghui Ye, Huan Zhao*, Zhihua Jiang, Keqin Li. Painting Generation from Classical Chinese: Dataset, Metric and Method [J]. IEEE Transactions on Pattern Analysis and Machine Intelligence.(CCF-A,第一作者,大修已修回)
[10] Huan Zhao, Zexin Zhou, Guanghui Ye*. Focus Before Reasoning: A Bidirectional Selection Framework for Noise-Mitigation in Knowledge-Based Vision Question Answering [C]. IEEE International Conference on Acoustics, Speech and Signal Processing. IEEE, 2026. (CCF-B,导师第一作者,本人通讯作者)
[11] Huan Zhao, Qianshuai Xue, Guanghui Ye*, Jina Yao, Kehan Wang, Jinfeng Chen. HiP-Bench: A Benchmark for Hidden-Picture Optical Illusion Generation [C]. International Conference on Learning Representations, 2027.(CCF-A,导师第一作者,本人通讯作者,在投)